
Limites de taxa e erros
Os limites e o que cada código de status significa.
Os modelos pagos não têm limites impostos pela Routerah: nada de limite de requisições por minuto, de tokens por minuto ou de requisições simultâneas na sua chave ou conta. Cada provedor upstream tem sua própria capacidade. Quando um está ocupado, passamos para o próximo, então um 429 ou 503 em um modelo pago só acontece quando todos os provedores dele estão ocupados naquele momento.
Os modelos gratuitos são limitados. Um 429 em um modelo gratuito pode vir de várias camadas:
- Nosso limite para modelos gratuitos: 1 requisição por minuto, por modelo gratuito, por usuário.
- Limites do upstream: o provedor por trás de um modelo gratuito atingiu o próprio limite.
- Orçamentos diários de tokens em alguns pools gratuitos, zerados à meia-noite UTC.
- Limites de tokens por minuto, disparados por prompts muito grandes.
Quando o limite de 1 por minuto dispara, você recebe os cabeçalhos padrão de limite de requisições:
HTTP/1.1 429 Too Many Requests
Retry-After: 38
X-RateLimit-Limit: 1
X-RateLimit-Remaining: 0
X-RateLimit-Reset: 1783198478
Retry-After é o tempo em segundos que resta na sua janela, não um valor fixo de 60. A mensagem cita o modelo pago, que não tem limite.
Alguns modelos pagos são oferecidos de graça com um limite de tamanho de requisição. Prompts acima disso retornam 413: Request body too large for gpt-4.1 model. Max size: 8000 tokens.
O limite vale apenas para a rota gratuita. O modelo pago aceita prompts de tamanho normal.
Os erros retornam JSON no formato de erro da OpenAI. code é um identificador estável. Um id de requisição é acrescentado a toda mensagem:
{
  "error": {
    "message": "Model \"gpt-5.5-typo\" is not offered here. Check the model name for typos, or switch to a model from our supported list. (request id: 20260705...)",
    "type": "new_api_error",
    "code": "model_not_found"
  }
}
Inclua o id da requisição nos chamados de suporte. Ele localiza sua requisição nos logs.
Se você ainda está configurando sua chave ou a URL base, comece pelo Início rápido
Os códigos de status que você realmente vai encontrar:
| Código | Significado | O que fazer |
|---|---|---|
400 | Requisição inválida: parâmetro incorreto ou prompt bloqueado pela moderação. | Corrija a requisição. Repetir sem mudar falha de novo. |
401 | Chave ausente, inválida, expirada ou desativada. | Confira o cabeçalho Authorization e a Tokens page. |
402 | O limite de gasto próprio desta chave se esgotou. | Aumente o limite da chave ou crie uma chave nova. |
403 | Saldo zerado, modelo não permitido para esta chave ou IP fora da lista autorizada. | Recarregue, ou verifique as restrições de modelo e de IP da chave. |
413 | A requisição passa do limite de tamanho do teste gratuito do modelo. | Encurte o prompt ou troque para o modelo pago. |
429 | Um limite de taxa disparou (veja os tipos abaixo). | Aguarde os segundos de Retry-After e depois tente novamente ou troque de modelo. |
500 | Algo falhou do nosso lado ou no provedor upstream. | Tente de novo após uma breve espera. Relate erros 500 persistentes. |
503 | Todos os provedores ocupados, ou o nome do modelo não existe. | Leia a mensagem: ocupado passa em minutos, um erro de digitação não. |
Duas situações bem diferentes compartilham o status 503. A primeira é congestionamento temporário:
HTTP/1.1 503 Service Unavailable

{
  "error": {
    "message": "All providers for model \"kimi-k2.6:free\" are busy right now (they hit their rate limit). This is not a spelling error. Please try again in a little while, or switch to another model. (request id: 20260705...)",
    "type": "new_api_error",
    "code": "get_channel_failed"
  }
}
get_channel_failed significa que todos os provedores gratuitos daquele modelo atingiram o limite. Isso passa em minutos: tente de novo ou troque de modelo. model_not_found significa que o nome não resolve; repetir nunca ajuda. Procure erros de digitação ou consulte o catálogo.
Trate get_channel_failed como recuperável e model_not_found como erro definitivo.
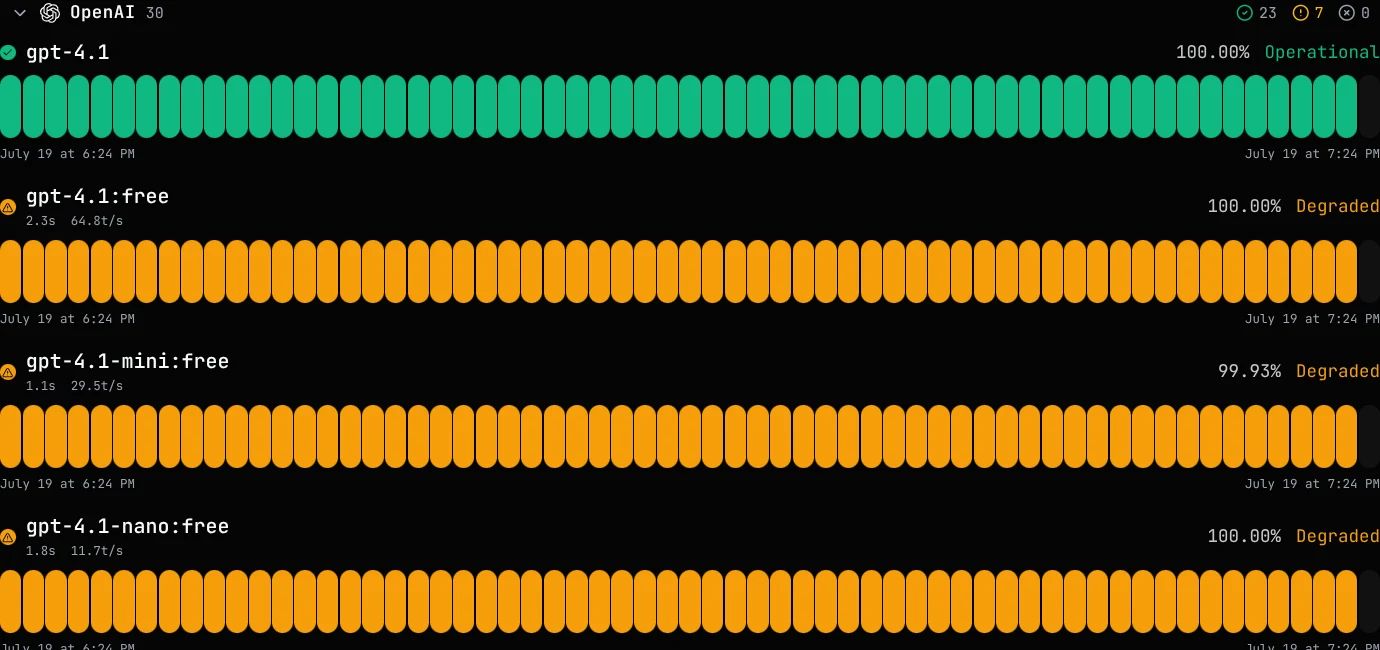
Um modelo que sumiu sob carga volta sozinho; para ser avisado assim que voltar, acompanhe-o em Notificações
Se sua chave fixa grupos de provedores, existe um terceiro 503 quando só os seus grupos fixados caíram, veja Fixação de grupos
Respeite o Retry-After em 429. Repita o 503 get_channel_failed após uma breve espera, ou troque de modelo. Não repita erros da classe 400.
Requisições com falha ou recusadas nunca são cobradas; como funcionam a pré-retenção e o estorno está em Conta e faturamento